eBPF:为什么它能把观测成本降到几乎为零

eBPF:为什么它能把观测成本降到几乎为零
隔壁老康难度 ★★★★★ · 前置:读内核源码从哪儿下手:别从开头的第一行开始 | 一句话结论:eBPF 的价值不在「能挂到内核函数上」,而在校验器保证了代码不会卡死、不会越界、不会死循环——正因为这个保证,内核才敢在生产系统上运行动态加载的代码。没有校验器,eBPF 就只是另一个
kernel module。
接口慢,strace 一挂就不慢了
一个接口偶发慢,一天几十次,每次几秒钟,监控上就是一根毛刺。我第一次碰到这种问题,本能反应是把 strace 挂上去,结果怪事发生了,挂上之后它就不慢了。后来才明白不是运气,ptrace 会把目标进程停下来检查,一停就改了时序,本来该卡住的地方被调试器拖成了别的形状,这也解释了为什么很多并发问题在调试器下永远复现不出来。(我那时候还不太信这个说法,觉得是巧合,直到连着三天都是挂上就变快,才认了。)
perf record 也试了,火焰图画得挺漂亮,但那几次慢的根本不在图上,它卡在 IO 等待里,CPU 是闲着的,采样器看见的就是一段空转,你要找的那几秒钟在图上是一片空白。我要的东西其实很具体,哪个进程、在哪个文件上、等了多久,这三样刚好落在所有现成工具的缝隙里。现在回头看,那一次的教训是我没分清采样和追踪的边界,采样器只回答 CPU 在忙什么,而等待这件事本来就不发生在 CPU 上。
下面这三行是我第一次用 bpftrace 时照着别人的博客抄的,把 $1 换成你要盯的进程号就行,比如 sudo bpftrace -e '...' 4210。
1 | sudo bpftrace -e ' |
挂上去,业务没受影响,延迟数据直接出来了。
这就是 eBPF 的日常用法,在不改变被观测对象行为的前提下,把耗时和上下文一起捞出来,而这件事在 ptrace 那一代工具里是做不到的,因为它必须让被观测的东西停下来,才能看见它,停下来这件事本身就是一种改变,你把一个正在等锁的线程暂停两毫秒,它等的那把锁的释放时机也跟着挪了两毫秒,等你放开它,原来的竞争关系已经不成立了。
以前那几种办法差在哪
| 方法 | 代价 |
|---|---|
strace / ptrace |
会让目标进程暂停,改变时序,高并发下可能放大问题 |
perf |
只看 CPU 采样,看不到「等待」和「阻塞」 |
systemtap |
要在目标机器上编译内核模块,很多环境不允许 |
| 内核模块 | 同上,而且一行崩溃能整机 panic |
| 打日志 + 重启 | 要改代码、要发布、可能复现不了 |
eBPF 的突破点是把用户写的代码编译成字节码,由内核里的校验器证明它安全,然后在内核里直接跑。重点在那句证明它安全,这是二十年来所有动态追踪方案都没解决的核心问题,不是没人想到往内核里插代码,是没人敢在生产机上插一段自己都没把握的代码,因为内核模块里的一个空指针会让整台机器直接 panic,而一段 eBPF 字节码最多是被校验器拒绝,然后你在日志里读到一段看不懂的报错。
内核凭什么敢跑别人写的代码
eBPF 是内核里的一个虚拟机,加载的字节码必须经过校验器证明「不会越界、不会死循环、不会调用未授权的函数」,通过后挂到指定的执行点上运行。
三个部件缺一不可。
  graph TD
    A["用户态程序<br/>C / Rust / bpftrace 脚本"] --> B["编译成 BPF 字节码"]
    B --> C["bpf() 系统调用"]
    C --> D["内核校验器<br/>证明安全性"]
    D -->|通过| E["JIT 编译成机器码"]
    D -->|拒绝| F["返回错误 + 校验日志"]
    E --> G["挂到 kprobe / tracepoint / XDP ..."]
    G --> H["事件触发时执行"]
    H --> I["写入 ring buffer / map"]
    I --> J["用户态读取"]
校验器就卡在中间那一步,没有它,eBPF 只是一条加载流程更麻烦一点的 kernel module,多了个编译器,多了几个系统调用,仅此而已,而它凭什么能让人放心,答案全在那个证明上。所谓证明,是把一段代码在所有可能输入下的行为都推一遍,推到每一条路径的结论都落在允许的范围内,这件事听起来比试跑麻烦得多,但它有一个试跑永远给不了的好处,就是不依赖运气,试跑只能覆盖它碰巧走到的那些分支,而证明覆盖的是所有分支,包括那些你根本没想过的输入组合。
校验器挑刺到什么程度
我刚开始写 eBPF 程序时最想不通的一点是,它凭什么在代码跑起来之前就知道这段东西不会炸,这个问题憋了我挺久,直到有一天认真去翻了一圈资料,才发现自己一直想错了方向。
我当初以为校验器是在后台偷偷试跑一遍,跑崩了就回滚,后来翻了源码才明白它一条指令都不执行,它把每条指令、每条分支都走一遍,走到哪一步就记下当时每个寄存器里是什么类型的值,走完全部路径没有一条能越界、能无限转、能调到不该调的 helper,才算通过,所以它给的是证明,不是抽查。这个误解让我很久没想通它为什么连一个明显的死循环都发现不了,因为试跑的话应该当场就卡住了。
下列三类条件,缺一条都过不去。
内存访问必须在边界内
1 | // 校验器拒绝 |
这就是为什么 eBPF 程序里到处是 if (!p) return 0;,不是风格,是不写校验器就不让过。
它不相信你,也不相信任何没有写出来的东西,你脑子里那个 p 一定不为空的事实,在它的推导过程里根本不存在,所以每一条解引用之前都得有一行看得见的检查,这也是 eBPF 代码看起来啰嗦而实际不能删的原因。刚写的时候我很烦这些 if (!p) return 0;,觉得是给编译器看的废话,后来自己写了个把 map 查出来的值直接下标的程序,被拒了三次才明白,那行检查不是在哄校验器,是在替未来读代码的人把你当时的假设写下来。
循环的上界必须能被证明
4.14 之前完全不允许循环,只能靠 #pragma unroll 展开。bounded loop 要到 5.3 才放开,在那之前校验器遇到回边(back-edge)直接返回 -EINVAL。放开之后,循环变量仍然必须能被证明有界:
1 | // 拒绝:i 的上界不可知 |
while 是同一版放开的,校验器不区分 for 和 while,只看能不能证明循环会在 1,000,000 条指令内结束。这个数不是给人看的,是校验器算出来的,它是所有路径上指令数的上界,某一条路径一旦可能越过它,加载当场就失败,而且报错信息通常只说指令数超了,不会告诉你是哪一圈转多了,这一点让早期写 eBPF 的人非常难受,因为你得自己顺着所有分支数一遍。
只能调白名单里的 helper
eBPF 程序不能随便调内核函数,只能调白名单里的 helper。
| helper | 作用 |
|---|---|
bpf_map_lookup_elem |
查 map |
bpf_ktime_get_ns |
拿纳秒时间 |
bpf_get_current_pid_tgid |
当前进程 |
bpf_probe_read_user |
安全读用户内存 |
bpf_trace_printk |
调试打印(慢,别在生产用) |
bpf_perf_event_output |
写 perf ring buffer |
每个 helper 的可用性还取决于程序类型。一个 XDP 程序不能调 bpf_get_current_pid_tgid,因为 XDP 在网卡驱动里跑,没有当前进程这个概念。这类限制写的时候不报错,加载的时候才炸,而且炸的位置跟你写错的地方通常隔着好几屏。
bpftool feature probe 能列出当前内核支持哪些 helper,想知道自己手里这台机器能干什么,一条命令的事。
名字里的 BPF 是另一个东西
都叫 BPF,cBPF 和 eBPF 是两码事,它们的区别不在新旧,而在设计目标,一个是为包过滤设计的极简指令集,一个是被硬塞进追踪和网络两个领域的通用虚拟机。
| cBPF | eBPF | |
|---|---|---|
| 寄存器 | 2 个(A、X) | 11 个(r0-r10) |
| 位宽 | 32 位 | 64 位 |
| 用途 | tcpdump 的过滤器(-d 能看到那几条指令) |
追踪、网络、安全 |
| 内核位置 | net/core/filter.c |
kernel/bpf/ |
tcpdump -d 'tcp port 80' 显示的就是 cBPF:
1 | tcpdump -d 'tcp port 80' 2>/dev/null | head -8 |
1 | (000) ldh [12] |
这段和 eBPF 字节码长得很像,但指令集不同。现代 tcpdump 在 Linux 上其实已经会先翻译成 eBPF,-d 显示 cBPF 只是为了可读性,你看到的是一份面向人眼的历史遗留格式。
挂载点决定了它能调什么
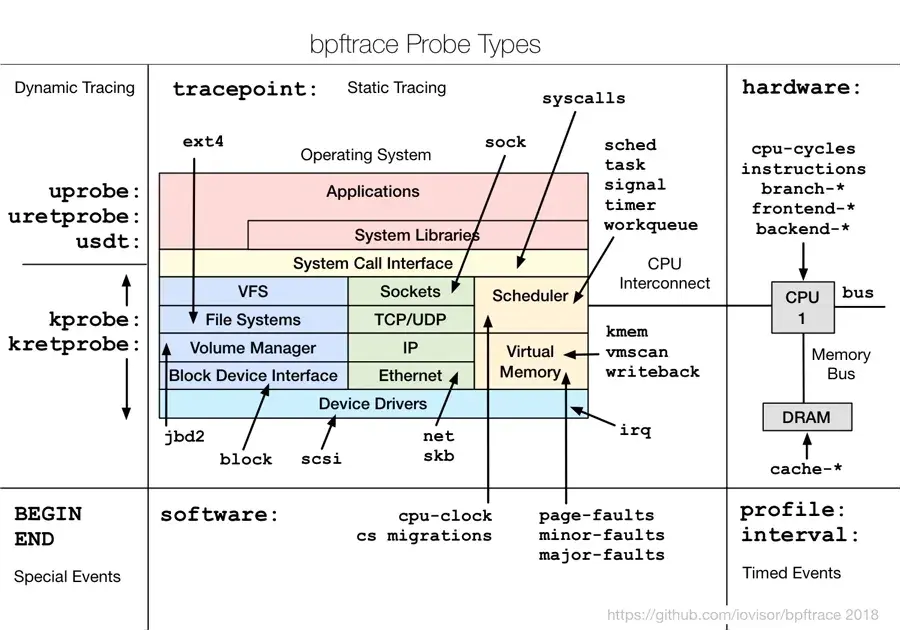
eBPF 能挂的地方很多,按用途分主要这几类。
| 类型 | 挂在哪 | 典型用途 |
|---|---|---|
kprobe / kretprobe |
任意内核函数入口/返回 | 内核追踪 |
tracepoint |
内核预埋的静态探针 | 稳定追踪(首选) |
uprobe / uretprobe |
用户态函数 | 应用追踪 |
perf_event |
硬件/软件性能事件 | 采样分析 |
XDP |
网卡驱动收包最早期 | DDoS 防御、负载均衡 |
tc / cls_bpf |
流量控制层 | 网络策略 |
cgroup_skb |
cgroup 级别的包过滤 | 容器网络策略 |
lsm |
安全钩子 | 访问控制 |
tracepoint 比 kprobe 稳定得多。tracepoint 是内核 ABI 的一部分,名字和参数格式都有承诺,kprobe 挂的那些函数名,可能下个版本就改名、被内联,或者整个函数消失,而这些变化在发行版的 changelog 里往往只有一行,还是写在几万行的变更说明里,你要不是天天盯着根本不会看见。(我有一次升级内核之后一个挂了半年的探针直接不加载了,翻了半天才发现那个函数被合并进了另一个文件。)
生产上能用 tracepoint 就别用 kprobe,这句话我一开始当口号听,后来被那次升级教育过才真信。
bpftrace 项目自己有一张图,把这几类挂载点摆在了同一张表上,左边是动态插桩(uprobe/kprobe),中间是静态探针(tracepoint,按子系统分好了组),右边是硬件和软件事件。图有点旧,但分类至今没变:
map 是程序唯一的出口
eBPF 程序本身只能返回一个整数,要带数据出来必须过 map,这也是它和内核模块最大的差别之一,模块可以直接改内存里的任何东西,而 eBPF 只能往 map 里写。
| map 类型 | 用途 |
|---|---|
BPF_MAP_TYPE_HASH |
通用哈希表 |
BPF_MAP_TYPE_ARRAY |
定长数组(最快) |
BPF_MAP_TYPE_PERCPU_HASH |
每 CPU 一份,无锁 |
BPF_MAP_TYPE_RINGBUF |
环形缓冲(5.8+,取代 perf buffer) |
BPF_MAP_TYPE_STACK_TRACE |
存调用栈 |
BPF_MAP_TYPE_LRU_HASH |
满了自动淘汰 |
PERCPU_HASH 是性能关键。普通 hash 多个 CPU 同时写要加锁,per-CPU 版本每个 CPU 写自己的副本,零竞争,代价是你得在用户态把各个 CPU 的副本加起来。
RINGBUF 是现在的推荐做法。perf buffer 每个 CPU 一个 buffer,核心数一多内存开销很可观,已经在被淘汰的路上。
一次加载要走完哪几步
  sequenceDiagram
    participant U as 用户态
    participant K as 内核
    U->>K: bpf(BPF_PROG_LOAD, 字节码, license)
    K->>K: 校验器逐指令验证
    K->>K: 类型推导 + 边界证明
    K-->>U: fd(失败则返回错误 + log)
    U->>K: bpf(BPF_LINK_CREATE, 或 perf_event_open)
    K->>K: JIT 编译
    K->>K: 挂到目标点
    Note over K: 事件发生 → 执行机器码
    K->>U: 结果写入 ringbuf / map
    U->>K: bpf(BPF_MAP_LOOKUP_ELEM, ...)
几个容易忽略的细节:
- 校验器是静态证明,不是运行时检查。它不运行程序,而是把每条指令、每条可能的路径都模拟一遍。
- 指令数上限有两道,非特权 4096 条(
BPF_MAXINSNS),特权 1,000,000 条(BPF_COMPLEXITY_LIMIT_INSNS)。这不是以前 4096、后来放宽的关系,是两道并行的门槛,看加载时有没有CAP_BPF或CAP_SYS_ADMIN。 - JIT(
net.core.bpf_jit_enable)在上游默认是关的,但主流发行版编内核时开了CONFIG_BPF_JIT_ALWAYS_ON,所以你真去读通常是 1。关掉之后解释执行慢十倍以上。 - 必须声明 license。有些 helper 只对
GPL开放,加载时校验。
校验器怎么知道那个指针能不能用
它会对每条指令记下寄存器里装的是什么类型的值,然后按这个类型往下推。
1 | r1: map_ptr (valid) |
这就是 eBPF 里要频繁用 bpf_probe_read_* 的原因,校验器无法证明用户传进来的这个指针有效,那就交给 helper,让内核在运行时代为检查。
bpf_probe_read_user 在运行时做 access_ok,失败返回 -EFAULT,不会崩。用运行时的检查换编译期的可证明性,eBPF 从头到尾都在做这笔交易,理解了这一点,很多看起来别扭的写法就都顺了。
加载完它就一直挂在那里
eBPF 程序加载之后一直挂在钩子上,直到对应的 fd 关闭,或者被显式卸载。
1 | sudo bpftool prog list |
bpftool 是 eBPF 的 ps。排查这个 kprobe 到底被谁占着,只能靠它。
内存限制是个老坑。RLIMIT_MEMLOCK 在裸机上还是 64KB 这个量级,systemd 管的机器通常已经被抬到 64MB 甚至不限,很多 eBPF 工具就是在这里第一次失败的:
1 | bpf: map create failed: Operation not permitted |
改法(ulimit -l 只能放宽到硬限制以内,普通用户直接 ulimit -l unlimited 会报 Operation not permitted,而且只对当前 shell 有效):
1 | ulimit -Hl # 先看硬上限是多少 |
5.11 之后改用 memcg 记账,这个限制基本消失了。但在老内核上,它仍然是第一大故障原因,而且报错信息只字不提内存锁,只说一句 Operation not permitted,第一次撞上根本想不到是这里。
那几十纳秒是从哪省下来的
三个原因。
一是 JIT 编译成机器码,没有解释器开销,和内核原生代码一样快,二是强制的代码简化,早期不允许循环,不允许阻塞,不允许睡眠,程序本身就被压得很短,三是没有上下文切换,程序在触发它的那个 CPU 上直接执行,不换线程,不进用户态。这三条里第三条最容易被低估,因为上下文切换的代价从来不在切换那一下,而在切回来之后 cache 已经全凉了,一次切换可能只花两微秒,可你重新把热数据装回 L1 要花几十微秒,追延迟的人算的是后面那笔账,不是前面那笔。
| 方案 | 单次开销 | 数量级依据 |
|---|---|---|
kprobe(无 eBPF) |
~1~3 微秒 | 要把指令换成 int3、触发异常、走 do_int3、再补回原指令 |
eBPF + tracepoint |
~100~300 纳秒 | 静态探针点,走预置的 __bpf_trace_* 调用 |
eBPF + fentry(5.5+) |
~50~100 纳秒 | 函数入口直接插一条 call,无异常、无上下文切换 |
| eBPF + XDP | ~50 纳秒 | 在 netif_receive_skb 之前,包里一进来就跑 |
这组数字给的是数量级,不是精确值。它们来自 Brendan Gregg 的 bpftrace/perf 实测与 vmtest 基准,随 CPU、内核版本、探针在不在热路径上变化很大。想在自己机器上量,最直接的办法是拿同一个空函数,分别用三种方式挂上去,看 bpftrace 报的 @ns 直方图:
1 | sudo bpftrace -e 'kprobe:vfs_read { @start[tid] = nsecs; } |
数字会比你预期的散,但只要三种方式用同一套测法,相对关系是稳定的,这就够支撑能用 fentry 就别用 kprobe 这个判断了。
为什么数量级会差这么多,kprobe 的工作方式是把目标函数第一条指令替换成断点(int3),执行到这里时 CPU 触发异常、内核的异常处理程序接手、保存现场、调你的探针、再单步执行原指令、最后恢复断点,这一整套走下来,微秒级不奇怪。fentry(CONFIG_FUNCTION_TRACER + BTF)用的是编译器预留的位置(-pg 或 -mfentry 生成的 call __fentry__),内核在启动时把那个 call 的跳转目标改掉,直接跳到你的程序,没有异常、没有单步,代价只是一条原本就在函数入口的 call 指令换了个去处,这也是两者开销差出两三个数量级的根本原因。
fentry 是 kprobe 的现代替代品,前提是内核 5.5+ 且开了 BTF(/sys/kernel/btf/vmlinux 存在)。
所以挂 kprobe 有开销这句话是对的,换个 fentry 就没了。
它也会拖慢系统
不是零成本。三个场景会出问题:
- 挂在高频函数上,比如
vfs_read。每个调用都要执行一遍你的代码,100 纳秒 × 每秒 100 万次 = 10% CPU。 bpf_trace_printk写 debugfs,慢到不能用。它要格式化字符串,再写文件。- map 太大或者访问模式不好,cache miss 的开销会盖过计算本身。
第一条最容易忽略。bpftrace 里 kprobe:sys_enter 这种全量挂在生产上是禁忌,我第一次这么干,负载直接上去一截,而且当时完全没往探针上想,查了半天以为是流量涨了。(那次之后我养成一个习惯,挂探针之前先看一眼这个函数每秒被调多少次。)
正确做法是加过滤条件(/pid == $1/),或者用 tracepoint 加采样。
装完之后的第一行
1 | # 主流发行版都有 |
linux-headers 是必需的,kprobe 需要知道函数的参数类型。
先数一下系统调用的次数:
1 | sudo bpftrace -e 'tracepoint:raw_syscalls:sys_enter { @[comm] = count(); }' |
几秒后按 Ctrl-C,会打印一张表:
1 | @[node]: 18234 |
这就是 eBPF 的入门三行:一条语句,全局系统调用画像。我第一次敲完盯着 node 那个数看了半天,两万多次里到底有多少是必要的,之前完全没概念。
再看哪个文件读得最慢:
1 | sudo bpftrace -e ' |
hist() 直接给出直方图:
1 | @ms[node]: |
一次就能看出是大部读得快、少数读得慢,还是普遍都慢。
把聚合放进内核
看是谁在 fork:
1 | sudo bpftrace -e 'tracepoint:sched:sched_process_fork { printf("%s -> %s\n", comm, str(args->child_comm)); }' |
args->child_comm 这种访问是 bpftrace 做的语法糖,底下帮你调了 bpf_probe_read。
抓 99 分位延迟也是同一个套路:
1 | sudo bpftrace -e ' |
这是内核里做统计、用户态只看结果这种分工的典型形态。每次调用都传到用户态再聚合,传输本身的开销就和你要观测的东西分不开了,hist() 的聚合在内核里完成,用户态拿回来的只是一张已经算好的表。
从 bpftrace 换成 C
bpftrace 是脚本,逻辑一复杂就得写 C。需要 clang 和 libbpf。
1 | sudo apt install clang llvm libbpf-dev |
1 | // hello.bpf.c |
SEC() 宏决定挂载点。tracepoint/sched/sched_switch 这一段要和 ls /sys/kernel/debug/tracing/events/ 底下的路径对得上,写错就是加载失败,而失败信息里通常只有一句 No such file or directory。
编译(还需要 linux-headers-$(uname -r) 才有 linux/bpf.h,Debian 系的 clang 有时不带 BPF target,先 clang --print-targets | grep bpf 确认):
1 | sudo apt install clang llvm libbpf-dev linux-headers-$(uname -r) |
-target bpf 是关键,它生成 BPF 字节码,不是 x86 机器码。
-g 把 BTF 信息保留下来,现代 libbpf 的 CO-RE(一次编译,多内核版本运行)全靠它。
CO-RE 解决的是哪个问题
写内核探针最烦的事:结构体字段偏移随内核版本变。你在 6.1 上编译的程序,拿 task_struct->pid 的偏移 1208 去读,拿到一台 5.15 的机器上跑,读到的就是别的字段,数据看着有,全是错的,不报错。老办法是在运行时查 vmlinux 的调试符号现算偏移,或者给每个内核版本各编一份。CO-RE(Compile Once, Run Everywhere,5.2 起)换了路子:
- 编译时
-g生成 BTF(BPF Type Format),把源码里用到的结构体布局记下来,但不写死偏移; - 程序里用
BPF_CORE_READ(task, pid)、bpf_core_field_exists()、BPF_CORE_READ_INTO()这类宏,编译器把它们转成重定位记录; - 加载时 libbpf 拿目标机器的
/sys/kernel/btf/vmlinux(内核自带的 BTF,CONFIG_DEBUG_INFO_BTF=y),对比两份 BTF,把偏移补进指令里。
1 | pid_t pid = BPF_CORE_READ(task, pid); /* 而不是 task->pid */ |
BTF_CORE_READ 这类宏里还带一层 bpf_probe_read_kernel,所以顺手解决了直接解引用内核指针会被校验器拒这件事。
它解决不了的部分,得诚实说清:
- 函数被删了、改名了 → 加载直接失败(
fentry尤其脆)。 - tracepoint 的
format文件变了 → 字段偏移照样错,BTF 管不到。 - 结构体字段被拆成嵌套结构 →
BPF_CORE_READ能跟、手写的偏移不能跟。
所以 CO-RE 之后一次编译处处运行这话只对结构体字段成立。真要跨大版本内核,还是得准备降级路径(bpf_core_field_exists() 判断字段在不在),而我第一次用这个宏的时候忘了写 else 分支,程序在一台老机器上静默丢了一半数据。
加载失败该看哪里
1 | sudo bpftool prog list |
link 是 5.7 之后的概念。一次加载可以创建多个 link,bpftool link 才是谁挂在哪儿这个问题的准确视图。
再看内核支持什么:
1 | sudo bpftool feature probe | head -40 |
1 | Scanning system configuration... |
这个输出能立刻回答为什么我的 eBPF 程序加载失败。三个最常见的原因:
unprivileged_bpf_disabled = 1且当前不是 root;- 内核版本太老,没有这个 helper;
RLIMIT_MEMLOCK不够。
校验器拒绝长什么样
1 | sudo bpftrace -e 'kprobe:vfs_read { $p = ((int *)1); print(*$p); }' |
报的是:
1 | stdin:1:1-33: ERROR: Probe not found |
或者更典型的一种:
1 | invalid read from stack... |
想看完整的校验器日志(debugfs 没挂的话先 sudo mount -t debugfs none /sys/kernel/debug,另外得有程序正在往 trace_pipe 写,否则这条命令会一直挂在那里):
1 | sudo cat /sys/kernel/debug/tracing/trace_pipe |
uprobe 能看见明文这件事
1 | sudo bpftrace -e ' |
这是 eBPF 最有名的用途之一:uprobe 挂在用户态函数上,进程内部的明文直接打出来,几行脚本就能抓到进程往 TLS 里塞的东西。
它同时也是安全的噩梦。能挂 uprobe,就能看到进程里的所有密钥,所以 unprivileged_bpf_disabled 在大多数发行版里是 2,完全禁止非特权用户。(我刚知道这件事的时候第一反应是这也太危险,第二反应是查了一下自己机器上的值,发现早就是 2 了。)
再往上一层是 Cilium 的 hubble、Pixie 这类东西。它们都是 eBPF 的上层应用,把原始的追踪能力包装成服务调用图和 HTTP 指标,看起来像另一类产品,底下跑的还是上面这些机制。读懂它们的前提,是先知道 ringbuf 里那些数据是怎么来的,而这件事我在第一次装 Cilium 的时候完全没概念,只当它是个更花哨的 tcpdump,直到有次丢包查不下去,才回头把前面那些东西补上,补完才发现最难的不是学会 eBPF,是先知道自己缺的是哪一块。
那些流传很广的话,错在哪一层
eBPF 是内核模块的替代品,这个说法定位就不对。内核模块能改内核状态、能做任意事,eBPF 只能读(除非用 bpf_probe_write_user,而且它被严格限制),eBPF 更安全,能力也窄得多,它不是替代品,是一把更小但更安全的刀。这两者最本质的差别在于内核模块是内核的一部分,它出问题就是内核出问题,而 eBPF 是一段被证明过的客人,它出问题只会被拒绝加载,这个差别不是程度上的,是性质上的。(我一开始也把它当成模块的轻量版,直到看见一个模块把整台测试机搞重启。)
eBPF 零开销,这话得看用在哪。单次几十纳秒,在高频函数上累计起来不小,vfs_read 这种每秒百万次的函数,挂一个 100 纳秒的程序就是 10% CPU,这个数我实测过,跟算出来的一致,而 10% 在一个已经很饱和的服务上就是压垮骆驼的那根草。
校验器通过就绝对安全,这话过了。校验器是软件,内核历史上出过多次校验器绕过漏洞(CVE-2021-3490、CVE-2021-31440 等),它是很高的门槛,不是绝对保证。必须编译内核才能用这句也不对,内核 4.x 之后都内置了 eBPF,只要开了 CONFIG_BPF_SYSCALL=y,而主流发行版基本都开着。
要 5.x 才能用,这句得看具体功能。bpftrace 需要 4.9+,fentry 需要 5.5+,ringbuf 需要 5.8+,CO-RE 需要 5.2+ 和 BTF 支持,混在一起说会把人吓退,好像非得上一台新机器才能开始玩,实际上大多数排查用到的只是最早那几个功能。
CO-RE 之后一次编译到处运行完全成立,这句只对结构体字段成立,它适配不了函数被删掉,也适配不了 tracepoint 格式变了这一类变化。bpf_printk 可以用来调试也只算半句真话,它写的是 debugfs,慢到会把你要测的东西本身拖变形,能用几次,不能用一晚上。
挂 uprobe 是安全的,恰恰相反。它能读到进程里的任何数据,包括密码、token、TLS 会话密钥,这是严重的安全边界问题,不是普通调试手段,这也是为什么给它装上限制之后,很多原来靠它实现的方案被迫换成了在应用层插桩。
归结成几条
- eBPF 的核心是校验器:它静态证明「不越界、不死循环、不调未授权函数」,这个保证才让内核敢在生产上运行外部加载的代码。
- 加载、校验、JIT、挂载、事件触发执行、写 map,六步,没有例外。
- 能用
tracepoint/fentry就别用kprobe,后者既不稳定,也慢一个数量级。 - eBPF 程序里满地的
if (!p) return 0;不是啰嗦,是校验器要求。 PERCPU_HASH和RINGBUF是性能关键;bpf_trace_printk在生产上是禁忌。- 开销不是零:高频函数上累计可观,必须加过滤条件。
bpftool feature probe能一次回答「为什么加载失败」;RLIMIT_MEMLOCK是老内核上的经典坑。- 能挂
uprobe就能读到明文和密钥,这才是unprivileged_bpf_disabled=2的原因。
写到这里,eBPF 能回答的问题基本都覆盖了:一次调用花了多久、走了哪条路径、在哪个文件上等的。但它回答不了 CPU 把时间烧在了哪条指令上,那还得回到采样器那边。perf top 里那些 [unknown] 的符号,是另一个方向的麻烦。