三色标记、写屏障,还有那句 gc 1
三色标记、写屏障,还有那句 gc 1
隔壁老康难度 ★★★★☆ · 前置:select 有多个 case 都就绪,会选哪个 | 一句话结论:三色标记负责记账,真正让 GC 和业务代码同时跑起来的是写屏障,而停下来的只有首尾两段,这次各 0 毫秒,开销全摊进了并发标记那 0.55 毫秒。
我第一次认真看 gctrace 的输出,是因为一个服务的内存曲线一直往上走,我得先弄清楚到底是哪一段在涨。把 GODEBUG=gctrace=1 打开之后,日志里刷出来的就是这样一行东西,前面那两个字母我还认得,后面全是加号、斜杠和箭头,一行里塞了十来个数。当时我照着搜到的说法,把 3->4->1 MB 当成堆的当前大小读了一遍,读完还是不知道它跟我那条曲线有什么关系,只知道量级在几兆上下,而线上那个服务早就不是这个量级了。那阵子我一直在别处找原因,翻定时任务、翻连接池、翻某个第三方包是不是自己在攒东西(现在回头看,答案在日志第一行就摆着,我压根没顾上看括号里写了什么)。
后来我干脆写了个最小的程序,先把堆推到 64MB,再自己手动调一次 GC,把别的东西都摘掉,输出才稳定下来,我才敢一行一行拆它。
环境是本机的 go1.27.2,windows/amd64,GOMAXPROCS 设成 32。
1 | GODEBUG=gctrace=1 go run . |
1 | gc 1 @0.054s 0%: 0+0.55+0 ms clock, 0+0/0/0+0 ms cpu, 3->4->1 MB, 4 MB goal, 0 MB stacks, 0 MB globals, 32 P |
我把这四行原样贴在这儿,下面所有的拆解都对着它们说,不再另外造例子。后两行带 (forced),跟前面四次不是同一类触发,先放一放,等前面那几块认全了再回来看它们。
一行 gctrace 里有十来个字段
这一行按逗号切成十来块,从前往后依次是第几次回收、距程序启动多久、GC 占掉的 CPU 时间比例,然后是三段墙钟、三段 CPU 时间、三个内存数、一个目标值,最后是栈和全局变量的占用,以及参与的处理器数量。
看上去密,其实每一块的位置都是固定的,认下来之后第二次看就顺了。四行里有三处会变,次数、耗时、那三个内存数,剩下的 32 P 和 0 MB stacks 从头到尾没动过,因为 GOMAXPROCS 我在启动之前设完就没再改。
剩下几个字段我对着文档一个个认的。
@ 后面那个时间一直在涨,五十四毫秒、五十五毫秒、五十七毫秒、五十九毫秒,四次回收全挤在五毫秒里,程序的预热全发生在这一段,中间别的事一件没做。
这个数是距启动的累计值,我头一回把它当成单次回收的耗时,拿它跟中间那半个毫秒比了半天,越比越不对。后来是靠什么认出来的?把两次采集的差值除了一下,量级对不上,才发现它是累计。
0% 那一格是 GC 占用的 CPU 时间比例,四行都写着 0,意思是这几次回收的量还没大到能在采样上显出比例。它不代表 GC 一点 CPU 都没花,只代表在那个口径下四舍五入成了零,真实的开销藏在小数点后面,这行字不舍得给你看。
这个零骗过我一次。那阵子我盯着这一格认定 GC 没怎么占 CPU,转头去查业务里的锁竞争,查了两天才发现方向从一开始就偏了,这一格算的是整场回收摊到总时间上的比例,四舍五入之后自然就写成零。
时间、比例、内存这三样认全之后,剩下两个 0 MB 顺手也能读掉,一个说栈上没占额外内存,一个说全局变量没占。这两项在真跑起来的服务里通常不会一直是 0。
我这几个小程序堆太干净了,干净到有点不像话,换到线上未必还是零。
0+0.55+0 是三段墙钟
三个数用加号连着,读法是三个阶段各自的墙钟耗时,依次是标记准备、并发标记、标记结束。首尾两段是必须停下来等 GC 的那两段,中间那段是 GC 和业务代码一起跑的那段。gc 1 写成 0+0.55+0,首尾都没花到能测出来的时间,真正吃时间的是中间那半个毫秒,gc 4 是 0+1.1+0,中间翻了一倍,两头还是 0。
CPU 那一块比墙钟绕,斜杠把它切成三份,依次是辅助标记、后台标记和空闲标记各分走多少。gc 1 和 gc 2 三份全是 0,gc 3 变成 0+0/1.0/0+0,后台标记分到一点零,gc 4 是 0+0.66/0.66/0+0,辅助和后台各占一半。斜杠切的是三种工作各自花掉多少 CPU,跟前面那三段墙钟不是一回事,我当初把这两组数当成同一件事,读错了好一阵。
3->4->1 MB 是三个时刻的堆大小
3->4->1 MB 这三个数的顺序是固定的,第一个是这一轮回收开始之前的堆大小,第二个是标记结束那一刻堆的峰值,第三个是回收做完之后还活着的量。
四行里这条三角一直在动,gc 1 和 gc 2 都是 3->4->1,gc 3 变成 3->5->2,gc 4 变成 4->6->2,起点从三兆抬到四兆,峰值从四兆抬到六兆,活下来的那份从一兆涨到两兆。但它们不亏,我要看的正是堆变大之后那一波。
涨出来的那部分活着的量,是程序自己还捏着的引用,回收器碰不了它。中间那个数比前后两个都大是常态,它记的正好是标记快做完、要收的还没收的那一刻,堆上既有该死的东西,也有新分配的东西。
后面那个目标值跟着一起动,gc 1 到 gc 3 都是 4 MB goal,gc 4 变成 5 MB goal。目标值算的是下一轮该在什么时候开,它盯着的是上一轮活下来多少,活下来的多,下一轮的门槛就跟着往上抬。
最后两行带 (forced),是我自己调 runtime.GC() 逼出来的,堆那时候已经被推到 48MB 和 64MB,日志里就写成 48->48->48 和 64->64->64。
三个数一模一样,是因为回收前后一点都没少,堆上几乎全是我还拿着的引用,能收的东西已经收干净了,剩下的一个字节也收不走。
这两次 GC 严格来说是白跑的,整块堆从头扫了一遍,代价却实实在在地付了(我本来指望它们把首尾那两段逼出数字来,结果两次都是零,倒是我对着那两行前后一模一样的长串愣了好一会儿,才反应过来不是日志没刷新,是真没东西可收)。
白色是还没访问到的
三色标记的做法是给每个对象记一个颜色,三个色各有各的意思:
| 颜色 | 意思 | 下一步 |
|---|---|---|
| 白 | 还没被访问到 | 可能被收掉,也可能还没轮到 |
| 灰 | 已经摸到了,指出去的还没扫完 | 待办,等着被拿出来处理 |
| 黑 | 自己扫完了,指出去的也扫完了 | 办完,不再动它 |
回收开始之前所有对象都是白的。整个过程只有四步:
- 从根出发,把根直接引用的那些对象涂成灰
- 从灰色集合里随便拿一个出来,涂黑
- 把它引用的那些白对象涂灰
- 重复第 2、3 步,直到灰色集合空掉
停下时还白着的,就是从根出发一条路都走不到的,可以整批收掉。根是什么,是栈上的变量、全局变量、寄存器里的指针这些,凡是从代码里能够直接摸到对象的入口都算根,标记从这些入口出发,一层一层往里走。这个过程里对象只在三个颜色之间单向走,白到灰,灰到黑,不会倒回去。正因为不回退,白名单在最后才有意义,它攒下的就是所有没被摸到的东西。把三种颜色想成一张工作表更顺手,白的还没进表,灰的在表上等着处理,黑的已经划掉。我第一次把这套颜色在纸上画出来,是为了给组里一个刚转 Go 的同学讲它跟引用计数差在哪,画到一半他问我灰色集合为什么不用排顺序,随便拿一个就行,我当场答不上来,回去翻源码才明白顺序在这套算法里真的不要紧,只要最后还没被摸到就一定不可达,谁先谁后都不影响结论。
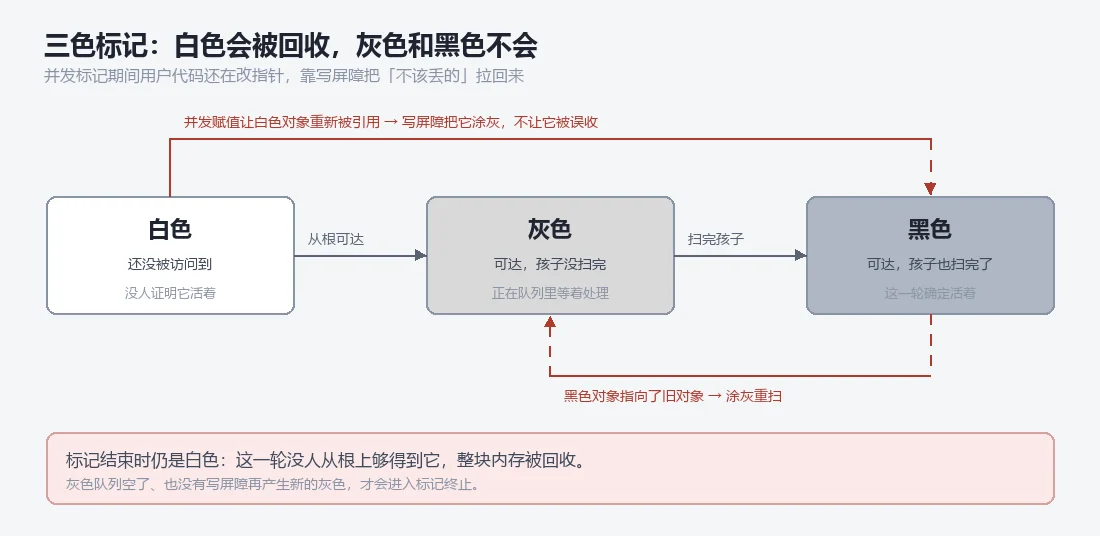
灰是待办,黑是办完,白是没轮到。这句话听上去像口诀,但真去读运行时里那段标记循环,每个分支对应的都是集合的增删,颜色只是贴在外面的标签,换成三个集合的进进出出,算法一个字都不用改。
黑指向白的那个瞬间
上面那套在 GC 占着整台机器的时候完全成立,标记把整堆扫完再开始收,中间没有人捣乱。问题是标记现在跟业务代码一起跑,程序照样分配对象、照样改指针,只要有一刻,一个已经涂黑的对象被改成指向一个还白着的对象,那个白的就永远等不到被涂灰的机会。
它其实还活着,可标记器把那个黑对象当成办完的跳过去了,不会回头再看它指了谁。等灰色集合空了,这个白的就留在白名单里被收掉,程序下次访问它就是访问一块已经还回去的内存,丢的不是内存而是那条从黑到白的边,崩的位置跟真正出问题的地方隔着十万八千里。
写屏障在赋值语句上加了一道关
  flowchart LR
    A["黑对象:已经扫完"] -->|"新写入一个白对象"| B["白的还活着,却没有变灰"]
    B --> C["灰色集合空了,标记结束"]
    C --> D["白的被当成垃圾收掉"]
    D --> E["下次访问:一块已经还回去的内存"]
解决办法是在赋值上动手脚,凡是可能破坏颜色不变量的赋值,都要先过一道屏障函数。插入写屏障管的是写进去的那一头,把一个指针塞进某个对象时,被塞进去的那个对象立刻涂灰,它就从白变成了灰,重新回到待办里。删除写屏障管的是被覆盖掉的那一头,一个指针被新值盖住之前,先把旧值指向的对象涂灰,等于在丢掉这条路之前先记一笔,让删边这件事不会顺手把对象也删丢。Go 用的是混合写屏障,两种都用上一部分,换来的好处是栈不需要重扫,这也是它被选中的原因。屏障函数本身很短,一次判断加一次涂灰,但它长在赋值语句上,标记期间每一次指针赋值都要走一趟。栈不用重扫这件事值得多说一句,栈上的指针变更太频繁,如果也要靠屏障一个个记下来,标记结束前就得把每个 goroutine 的栈重新走一遍,而那些正在跑的栈还走不干净,混合写屏障把栈这一块从重扫里摘了出去,代价是每条赋值路径上多一次判断。我头一回意识到它真的落在赋值语句上,是给一个把对象池写成链表的地方做压测,那段代码每往节点里塞一个指针,屏障就跟着跑一次,单看一次的开销小到可以忽略,可那个循环跑得极密,火焰图上涂灰的那几个函数居然排进了前面。
在赋值上加一道关,一次要付多少?我一开始以为是竞争,加了锁反而更慢,最后是同事提醒了一句,这东西本来就长在每一行赋值上(那阵子我确实一直在往锁的方向找,压根没往语言这一层想)。
首尾两段是零才算数
回到那四行日志。首尾两段为什么是 0,因为整场回收里只有这两段要停止整个世界。标记准备要把所有 goroutine 停在安全点上,标记结束要收尾,还要把该补的扫描补上,中间那段漫长的标记过程是跟程序一起跑的,谁也不用等谁。停一次世界的代价跟堆大小有关,也跟 goroutine 数量有关,堆越大要扫的根越多,要停下来的 goroutine 越多,停的时间越长。这几行里堆只有几兆,goroutine 也没几个,停一次的时间测都测不出来,所以两头才都写着 0。真要说的话,两个 0 是在告诉我这次回收的停顿小于这台机器能分辨的精度,不是告诉我它没停。停顿没测出来,不代表并发标记那一段是白给的,0.55 毫秒实打实花掉了,只不过它没有让程序停下来,而是摊到了所有正在跑的业务代码上,标记要占 CPU,业务代码要抢同一批 P,辅助标记那一段就是业务 goroutine 被拉去帮忙花掉的时间。我第一次真正感觉到这两段的分量,是在一个有点年头的服务上,那台机器的堆比这个小程序大两个数量级,GOMAXPROCS 也没这么阔气,同一个 gctrace,中间那一段还是零点几毫秒,两头却各冒出来几毫秒,加起来没有标称的那么吓人,可那几毫秒全落在推请求的线程上,前端报的尾延迟一下就能看出来(那时候我还不知道去看这两段,只知道接口偶尔慢一下,翻了两天日志才发现慢的那几下跟回收的时间对得上)。
所以并发标记期间程序会慢一点,这是设计里写好的交换。用一段均匀的变慢,换掉一次长时间的停顿,堆越大这笔账越划算,因为停顿的时间跟堆大小成正比。1.1 毫秒的并发标记对一次请求来说不算什么,一次真的停顿要是到了几十毫秒,超时就开始往外冒了。
结束统计里 HeapAlloc 停在 67760584
程序跑完,结束统计里 HeapAlloc 是 67760584,HeapSys 是 75137024,NumGC 是 7。我拿 67760584 跟 64MB 对了一下,64MB 是 67108864 字节,多出来的六十多万字节我没去深究,量级对得上就够了。
NumGC 记的是七次,我抄下来的只有六行,前面四行自动触发,后面两行带 (forced),差的那一次没留住。debug.SetGCPercent(-1) 返回的是 100,那是默认的 GOGC 值。整篇里最该记住的不是哪个数大,是所有数都小,真正要看的反倒是首尾那两段里的 0,0.55 毫秒、0.54 毫秒、1.1 毫秒放进一个要接请求的服务里,你感觉不到。