变量到底在栈上还是堆上
变量到底在栈上还是堆上
隔壁老康难度 ★★★☆☆ · 前置:函数是一等值,闭包只是它的一个用法 | 一句话结论:变量上不上堆不看类型也不看大小,只看它的地址能不能活过函数返回,报告里那几行就是编译器提前写下的判词。
第一次把 -gcflags='-m' 敲进终端那天,我盯着那三行输出看了很久,因为它们长得实在不像在跟人说话(当时第一反应是编译器在抱怨我代码写得乱,其实人家只是在陈述事实)。行首是文件名加行列号,后面跟一句英文,混在编译过程的其它输出里,很难抓。那次我只是顺手加了这个参数,看完随手就关了,一个字也没记住。真正让我回去翻它的是服务在高峰时段的内存曲线,每隔几分钟抬一个台阶,抬完不落。我一开始怀疑哪里漏了 close,把连接数和 goroutine 数都打出来,两个数字都很平,只有堆大小在涨。抓内存的时候看到满屏小对象,全挂在同一个函数名下,那个函数一共八行,我看过不下十遍,觉得它干净得没什么可优化的。那天下午我把编译输出重定向到文件里慢慢看,才发现自己读它的方向从一开始就是反的(我一直在找哪个对象大),而它想告诉我的其实是哪个地址漏了出去。
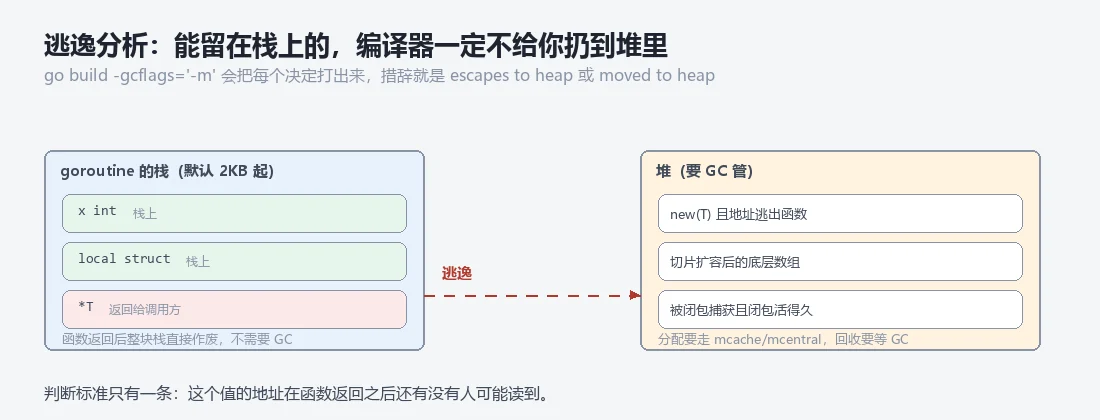
报告要回答的问题只有一个,某个变量的地址有没有活过函数返回。活着搬去堆,没活过留栈上,编译器在编译期定死,运行时不再参与判断。
报告里翻来覆去只有三种句子
摘要里的句子翻来覆去只有三种。第一种说某个函数能不能被摊平到调用点,句式是 can inline 加函数名。第二种说某个值必须分配在堆上,句式是 escapes to heap,主语可能是一个变量,也可能是一段还没落地的表达式。
第三种说某个原本在栈上的具名变量被挪走了,句式是 moved to heap 加变量名。
这三种句子混在同一份输出里,行首还带着同样的文件名和行列号,第一次看很容易把它们当成同一件事的三种说法。
| 输出长什么样 | 它在回答什么 |
|---|---|
can inline add |
这个调用会不会被摊开 |
make([]int, 0, 4) escapes to heap |
这个值住在哪 |
moved to heap: n |
这个变量原本能留在栈上,被谁赶走了 |
我头一年就是这么以为的,看到 escapes 两个字就往下滑,反正结论都是上堆。后来在一个缓存组件里栽了一次才明白,它们分别在回答三个互不相干的问题,能不能内联、这个值住哪、这个变量动没动。混着读的后果是抓错方向,我那次就是盯着 escapes 一路查下去,查了半天才发现真正该看的是上面那行 moved,因为那个变量原本是可以留在栈上的,是某个具体的写法把它赶走的。
moved to heap 那几个字就是线索。
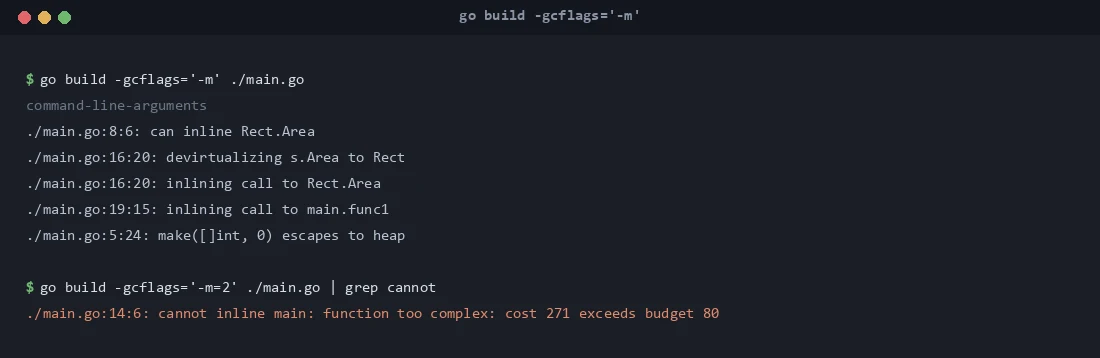
我手上这个小程序只有两个函数,一个 add,一个 main,跑一次 -m 出来三行。
1 | ./main.go:5:6: can inline add |
三行对应三个位置,5 行 6 列的 add 被判成可以内联,8 行 11 列那个 make 出来的切片被判成要上堆,12 行 25 列的 s 也一样。位置精确到列是有道理的,同一行里可能挤着好几个表达式,只给行号分不清说的是哪一个。再加一个 -m,输出立刻变厚,多出来的第一批行说的是代价。
1 | can inline add with cost 4 as: func(int, int) int { return a + b } |
第一行把 add 的代价算了出来,4,后面顺手把内联之后的样子写给你看,就是一句加法。这个 cost 不是时间也不是字节,它是一套写死在编译器里的计数规则,加一次、调一次、跳一次各自记几分,把这些项加起来得到一个可以互相比较的数,数越小越值得摊开。第二行是这个预算露出真面目的地方,main 的代价是 111,超了 80,于是不内联。这个 80 没有对应的编译参数可以调,-gcflags 里翻不到能改它的开关,它是编译器源码里的一个常数,换句话说,一个函数能不能内联,在写出来那一刻大致就定了,后面能做的只是把它拆小一点,让代价重新落回线内。代价是估出来的,你看不见每一行各占几分,只知道总数超了,所以拆的时候更多是靠试,改一版跑一遍,看那个数字有没有回到线下。拆小这件事也有反效果,函数体拆碎以后调用次数变多,指令缓存和分支预测的收益可能一起丢掉,所以我现在的做法是先看报告再动手,而不是看到 cannot inline 就拆。最后那行 flow 是另一种东西,它画的是推导路径,不是结论,行里的 ~r0 是编译器给未命名返回值起的名字,波浪号表示这个名字是它自动生成的,不是你写的,箭头连接两个存储位置,说明其中一边的地址被另一边接住了。
把场景换成一个闭包,输出会变得更有意思,因为两件本来不在一个层面上的事会挨在一起出现。
1 | ./main.go:6:2: moved to heap: n |
六行里有两行在说同一件事的两面。can inline counter 说这个返回闭包的函数可以被摊平到调用点,moved to heap 说它里面那个计数器被搬到了堆上。很多人看到前一行就松了口气,以为内联之后闭包就没有成本了,可后一行明明白白地告诉你,那个计数器还是走了。这两行同时成立不是矛盾,因为它们描述的维度根本不同,一个说代码最后落在哪个位置,一个说数据最后住在哪块内存,编译器把这两件事分开算,也分开报。
别把 can inline 当成一张免责声明,它只许诺了一件事,这次调用不再是跳转,别的什么都没许诺。
我在一个定时任务里吃过这个组合的亏。当时看到一个被高频调用的小函数,报告里写着 can inline,我就认定它没有分配,把它放在热路径上用了很久,直到内存曲线开始往上抬,才回去补了 -m -m,发现里面那个被返回的指针一直挂着。
moved 和 escapes 是两个动作
这两种措辞经常被当成同义词,其实差得很明显。escapes to heap 是对一个值下的结论,这个值必须住在堆上,它的主语往往是一段表达式。moved to heap 是对一个变量做的动作,这个变量本来可以住栈上,因为某些原因被挪走了,它的主语一定是个有名字的变量。
读报告的时候分不清这两者,就分不清哪些是没法避免的,哪些是自己写出来的。这份输出里最能说明问题的是 11 行那个 func literal,它报了 escapes to heap,下面却没有对应的 moved to heap,这说明逃的是函数字面量本身,它一个外部变量都没抱,所以没有谁的地址被带走。字面量逃逸和变量逃逸是两码事,前者带走的是那段代码加执行环境的整体,后者带走的是某个具体的格子。被 return 出去的字面量一定会逃,哪怕闭包里空空如也,函数值本身也是一个对象,它有类型,有环境,被交到外面之后,它的生命周期就不再由当前栈帧决定。
这一点经常被误解成只有捕获了变量才会上堆,实际上捕获只决定要不要额外搬一个变量,不决定函数值本身去哪。
15 行那个 does not escape 是反例,那个字面量是在原地直接调用的,用完就没了,编译器看得清清楚楚,所以它既没有逃,调用也省掉了一次间接跳转。
一行报告对应编译器做的一个决定。这两个词差的那一点,实际影响在哪?
地址漏出栈帧的五种写法
把这些报告里的句子归纳一下,能让变量上堆的写法就那么几种,每一种我都在真实代码里碰到过:
- 把局部变量的地址返回出去,函数返回之后调用方还攥着这个指针,栈帧不能留,只能搬
- 把地址存进一个包级变量,全局的东西活得比谁都久,它指到的地方自然不能是栈
- 把值塞进 interface,一旦装进接口,编译器看到的只是两个机器字,里面到底装的是指针还是值它不关心,保守起见一律上堆
第三种最容易误判,因为它藏在一行看起来完全无害的赋值里。
第四种是被闭包捕获,并且这个闭包活过了当前函数。第五种是放进 map 或者 slice,而那个容器本身逃逸了。
这五种的共同点是都让地址的寿命有可能长过栈帧,编译器判断不了,只能按最坏的一种处理。
第五种最常见,也最容易被忽略,因为代码里看不到任何取地址的符号,你只是往一个 map 里塞了一个结构体,看上去很安全。可 map 的桶分配在堆上,桶里存的每一个值都跟着在堆上,你塞进去的那个结构体的地址也就到了堆上。
slice 同理,底层数组在哪,元素就在哪。
装箱就是一次分配。
interface 那一条我踩得最多,写日志的时候习惯把字段拼成 map[string]any,每一个值都要装箱,一个请求拼十个字段就是十次。这种事在单测里完全看不出来,因为单测的请求量太小,垃圾还没来得及堆起来就结束了,等到线上流量真打进来,才发现这条链路的分配次数比业务逻辑本身还高。
更要命的是它出现在最不该出现的地方,日志本来是观测手段,结果自己成了开销来源。
账单最后是 GC 来收
上堆的代价不在分配那一下,分配器给一块新内存的速度很快,快到你在基准测试里几乎看不出两次分配的差别,真正贵的是这块内存之后要被人反复照顾。多一个堆对象,垃圾回收就多一个要遍历和标记的节点,多一份要扫描的指针,回收器是按对象数量组织工作的,不是按字节数组织工作的,一个小整数和一个大结构体在标记阶段都要走一遍,开销的差距远远没有体积的差距那么大。这就是那行 make 值得盯着的原因,它小得几乎不占内存,可它在账本上照样占一整行,每次清扫都要重新过一遍。一个被高频调用的函数,只要里面有一次分配,调用多少次就产生多少个对象,几分钟就能把年轻代填满,然后是一轮接一轮的回收,你把每轮的停顿加起来,会发现它比那次分配本身贵了几个数量级,而这条链路在 profile 里往往只显示成一次 GC,看不出源头在哪个函数里。
所以衡量一个改动值不值得做,看的应该是分配次数有没有降下来,而不是单次分配快了哪怕一点点。
sync.Pool 换的是次数不是速度
说到降分配,绕不开 sync.Pool。用法很直接,取的时候没有就新建,用完放回去,下次接着用,省掉的是新建那一步。代价藏在回收器里,池子里的对象随时可能在任意一次 GC 时被清掉,这是设计使然,不是实现上的缺陷,所以它不能当缓存用,你今天放进去的东西明天不一定还在,甚至这一次请求刚放进去,下一次请求就取不到了。
它适合那种创建成本不低、丢了也无所谓的临时对象(比如序列化用的缓冲区),比如解析用的临时切片。用它的前提是你已经确认了分配是瓶颈,并且这个分配确实频繁,没确认就上池子,多半是把一次很快的分配换成了一次加锁、一次类型断言和一次概率性的未命中,账面上更贵。
我现在读这份输出,是三步
跑一遍 -gcflags='-m',包大了输出几百行,硬读是读不完的,我现在先筛后读:
- 筛关键字:
escapes to heap和moved to heap各扫一遍,把有逃逸的位置记下来 - 看内联:把
cannot inline的行挑出来,注意后面跟的原因 - 回头看
-m -m里的 flow 行,找出从形参走到返回值的那条路径
第三步最费时间,也最容易被跳过。
三步的顺序不能换,前两步给出的是位置,第三步给出的是理由,没有位置的推导读起来只是一段符号,看完一屏也记不住自己到底想解决哪一处。
先看 flow 行是最容易迷路的一种读法,那些推导又长又绕,我试过两次,两次都是看完就忘。
报告只说搬到哪,不说该不该搬。
这两年多我把这套顺序走过很多次,最有用的其实不是哪个参数,而是那个习惯,看到一个分配,先问它的地址能活多久,再问这个分配一秒发生多少次。