切片的容量是这么长的,4 8 16 32 然后就不对了
切片的容量是这么长的,4 8 16 32 然后就不对了
隔壁老康难度 ★★★☆☆ · 前置:Go 只有值传递,切片也一样 | 一句话结论:append 触发的扩容容量由 runtime 里一条递推式算出来,再被内存分配器向上取整到最近的规格,所以它既不是翻倍,也不是一个能背下来的表。
848 是哪儿来的。512 不够装,按直觉翻倍就是 1024,屏幕上给的却是 848,既不是翻倍也不是 1.5 倍,我第一反应是自己打印的位置写错了,把某些变化漏掉了,于是另写了一段从空切片开始一个一个往上加,每变一次打一行,才看到完整的序列长什么样,也才发现前面那几个数漂亮得过分,从第八个开始全在乱跳。
这篇里的数全是在我自己那台机器上量的,换个版本跑出来不一样。那天晚上我才意识到 cap 给出的数字不是顺手给大一点,它背后有一整套确定的算法,只不过这套算法埋在 runtime 里,我写了小半年的 Go,从来没往里看过一眼,后来把那两处源码都翻出来对着打印结果推了一遍,才敢确定这不是某个版本的怪癖。三步都是设计好的:先算一个够装的理论值,再让分配器按大小分级往上抬一档,抬完再除回元素个数,三步各管各的,中间任何一段被跳过都算不出 848。这也解释了为什么单纯去看 growslice 会算不对,因为最后那一步向上取整发生在另一个文件里,函数名叫 roundupsize,它的任务是查一张表,把请求的字节数抬到最近的规格上。我最初抄了一份博客上的说法,讲的是 1.25 倍一路乘下去,照着那个算前几档全部对得上,因为它恰好也是翻倍,等到 512 这一档才露馅,那版说法省略了阈值判断,只保留了递推,看着简洁,实际上是错的。
数字是这么长出来的
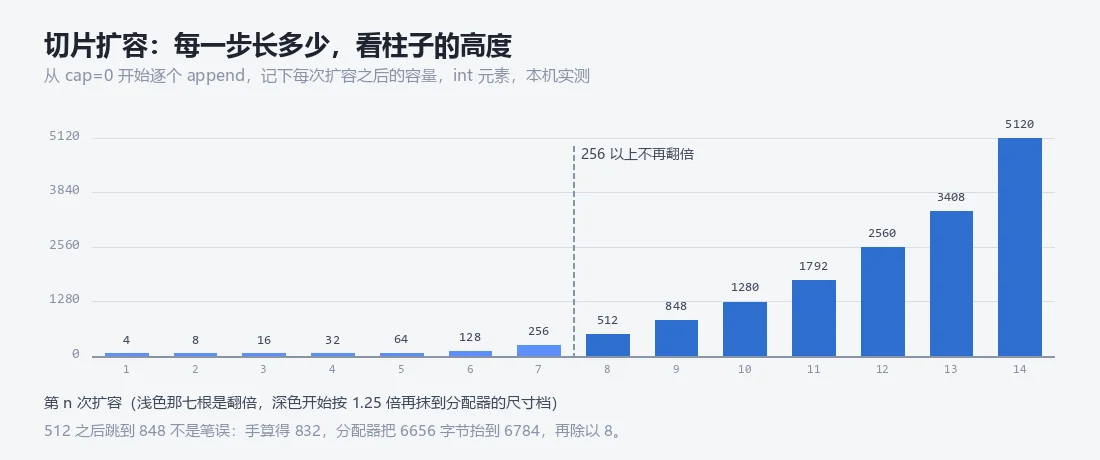
从空切片往后加九万个整数,容量发生变化的位置一共二十六个,全部打出来太长,前面这一段最有代表性,因为它把两种规律都露出来了。前面七个数字老老实实地翻倍,从 4 一路到 512,规律漂亮得让人放心(我一开始就是被这七个数字骗过去的),以为整张表都是这个形状,第八次扩容本该是 1024,实际给了 848,比预期小了一截,从此以后每一档的倍率都在 1.33 到 1.66 之间晃,512 到 848 是 1.66,848 到 1280 是 1.51,1280 到 1792 是 1.4,再往后越来越接近 1.25,等到二十万那几档倍率基本稳定在 1.26 左右不动了,我把这张表来回看了好几轮才承认前七个数的漂亮只是巧合。这些数既不是随机的,也不是某段历史代码留下来的包袱,每一次扩容都走同一条路,算出来的结果只跟旧容量有关,跟你跑在哪台机器上无关,二十六个变化点我对着源码核过,没有一个例外,顺带说一句,这张表在知乎和几篇公众号文章里被抄过很多次,抄错的版本里 848 常常被写成 1024,看上去更整齐,但你真跑一遍就知道不是。
我还见过一版把整段序列截到 512 就结束的,说是容量太大内存撑不住,其实加九万个 int 才几百 K,随便一台机器都能跑,截断纯属没跑完就写文章。
1 | 4 8 16 32 64 128 256 512 848 1280 1792 2560 3408 5120 7168 |
256 是一条分界线
真正决定容量的是 growslice 里的一个常数,源码在 D:\Go\src\runtime\slice.go 第 333 行,名字叫 threshold,值是 256。旧容量小于这个数的时候新容量直接取两倍,这就是前面那段干净的翻倍,一路从 4 翻到 512 都不带一点犹豫;旧容量到了 256 及以上逻辑换了一条路,反复执行一句递推,直到容量够用为止(也就是说 256 这个数字本身就是一个分水岭),低于它用小学数学就能猜对,高于它必须动笔算。我把那一句递推抄在纸上推了推。右移两位等于除以四,所以每次的增量是当前容量的四分之一再加上四分之三的阈值(也就是 192),这个 192 是固定项,不管容量多大都加这么多,它的作用是把小容量那一段的增长率托起来,避免在 256 附近出现太陡的跳变。
拿 512 那一档手算一遍,初始 newcap 是 512,第一次加上 (512+768)>>2 得到 320,加起来是 832,而这次要装下的长度是 513,832 已经够用,循环在这里停下,所以扩容只做了一轮。
手算到 832 的时候我停了一下,把它当成最终容量抄进笔记,第二天对着打印出来的 848 对不上,翻回去才发现少了一层向上取整,这一节整段重写过。这个界线为什么停在 256,而不是别的数?
1 | newcap += (newcap + 3*threshold) >> 2 |
内存分配器还要动一次手
832 个 int 是 6656 字节,这个数字不是分配器愿意给出的规格,它会向上取整到最近的大小分级,6656 落到 6784 那一档,再用 6784 除以 8 得到 848,这才是最后打印出来的那个数。这一层向上取整看着像浪费,其实是为了让不同大小的对象都能落进有限的几十个规格里,分配器维护空闲链表的时候只要管那几十个规格,不用管无限种大小,代价是每个对象都可能多出几十个字节的余量,这个余量在小对象上占比很高,在大对象上就几乎看不见了。
前面那张容量表里还藏着一件事,同样是 append,元素类型不一样,容量的台阶就不一样。
从这里往后,容量只跟类型宽度有关了。
我拿一个两字段的结构体试过,它占 16 字节,容量序列是 2 4 8 16 32 64,起步只有 2,因为 2 个就够 32 字节了,而 int 起步是 4;从 1024 开始往上加 byte,序列是 1024 1536 2304 3072 4096 5376 6912 9472 12288,第一次从 1024 到 1536 是 1.5 倍,手算正好对得上,1024 加 448 得 1472,1472 向上取整就是 1536。
分配器认的是字节数,元素个数只是除回去之后的结果,所以元素越胖容量台阶越矮,元素越瘦台阶越密。
网上流传过一个 1.25 倍的说法,那个讲的是更老的版本(我后来翻了一次还是没找到原始出处),只知道它对不上 512 这一档,手上没有第二个 Go 版本可以对着跑,就先这么记着。
扩容那一刻是三件事
append 发现容量不够,会申请一块新数组,把旧数组里有效的元素逐个复制过去,再把切片头里的指针和容量换成新的,三件事顺序不能乱,任何一步失败都意味着数据丢一半。复制这一步是关键,它复制的是元素本身不是指针,所以元素类型越大这一次复制的开销就越明显,一个几百字节的结构体切片扩容等于把整块内存搬一遍。
复制占的时间比分配长,元素越胖差得越多。
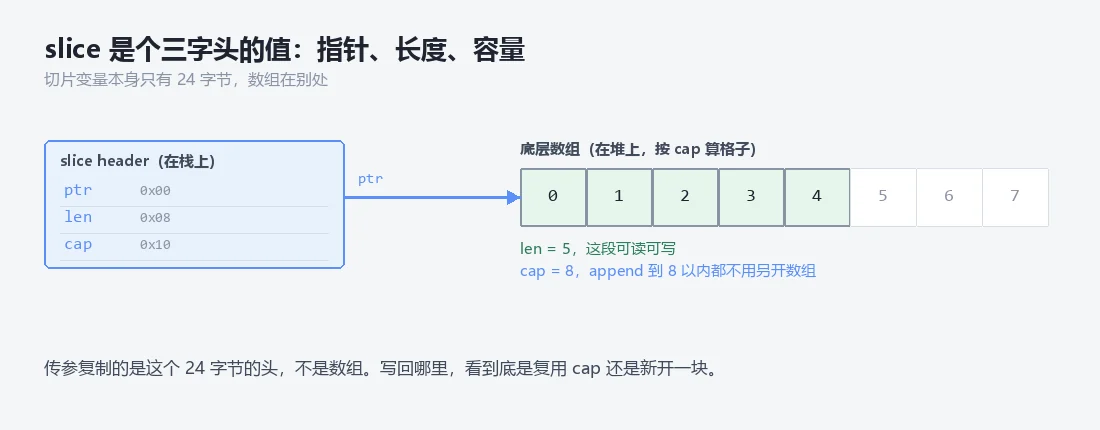
这也是为什么 append 的返回值必须接住,它返回的可能是换过头的新切片,而调用方手里的那个变量还是旧的头部,append 拿到的只是一个值,它没有办法反过来修改你那个变量。
我见过最隐蔽的一次。
复制那一步我后来单独量过,把复制和分配分开看,分配只做一次,复制要做很多次,同一个元素在几次扩容里会被反复搬。
有人在函数里对入参 append 完就 return,什么也没返回,函数内部的容量变了,外面的切片一个字节都没动,日志里打印的长度从头到尾没变过,看上去像数据丢失,数据没丢,是它进了另一个数组,那个数组在函数返回之后就没人引用了。
append 的返回值为什么必须接
如果不接返回值,s 就一直是 3 3,编译器不会提醒,因为 append 不接返回值在语法上完全合法,只是白干了一场。
1 | s := []int{1, 2, 3} |
返回值这三个字听着像提醒,其实就是事实:append 拿到的切片头是一个值,它在函数内部换成了新的指针,外面那个变量一无所知(我后来在评审里再看到这种写法),会先问一句这个 append 到底想改谁,问出来往往对方也没想清楚。
两个切片指向同一块内存
只要没触发扩容,append 就是往底层数组的下一格写,如果外面还有别的切片共享这块数组,那个位置的数据就被覆盖了。a 的长度是 2,容量是 5,因为从下标 1 切到 3,剩下的空间一直延伸到原数组末尾,cap 算的是从起点到数组结尾还有多少格,不是这一段自己的长度,append 写进去的 99 落在下标 3,那个位置原本是 4,于是 4 就这么无声无息地没了。
既然会互相覆盖,为什么平时很少撞上?
1 | base := []int{1, 2, 3, 4, 5, 6} |
这种覆盖不会报错,不会 panic,只能靠人自己记住。更麻烦的是两次 append 互相覆盖。两次都往同一格写,后写的赢,u 跟着变成 [1 2 4]。这个我在线上碰过一次。这种 bug 在单元测试里经常抓不住,因为测试里往往只 append 一次(这条路径根本没被走到),等它发作的时候,你看到的现象是某张表里一行莫名其妙的数据,而那一行在上一次跑的时候还是对的,于是你会先怀疑数据库、再怀疑缓存、再怀疑是不是有人手工改过数据,最后才想到去看看那个 append 的返回值有没有人接住。
1 | s := []int{1, 2} |
三索引切片是给谁用的
完整的三索引写法是 base[low:high:max],第三个数字限定的不是长度,它限的是新切片的容量。上一段那个例子改成 base[1:3:3],容量就是 2,append 立刻触发扩容,base 原封不动。
1 | base2 := []int{1, 2, 3, 4, 5, 6} |
代价是彻底的隔离吗,也不是,改元素照样共享,b[0] = 200 之后 base2 变成 [1 200 3 4 5 6],三索引只切断了 append 越界写的那条路,读和写元素这件事从来没被切断过。它真正的用处很窄,基本只有一个,就是把一段数据交给调用方,同时不希望对方的 append 改到你手里那块的后续内容,库函数返回切片的片段时用它比较安全,标准库里不少解析函数就是这么写的,返回的片段虽然只读,但依然用三索引锁住容量,免得调用方顺手一 append 就把原缓冲区改脏。我第一次用它是在一个解析函数里,返回的是一段包在缓冲区里的切片,后来调用方在那段上 append,把后面的数据写脏了,查了两天才查到,加上第三个数字之后这条路径就断了,代价是每次切都得算一遍 max 填几,算错一次又回到原来的坑里,只是坑换了个方向,写起来也啰嗦,读的人得停下来想一下这第三个数字是干什么用的(我后来只在跨包返回的地方用它),包内部自己用的切片懒得写。
预分配省下的是峰值
如果事先知道要装多少个元素,make([]int, 0, n) 直接一次分配到位,整个 append 过程零扩容。我用 append 一个个加二十个整数,容量是 32,白白浪费 12 个槽,写成 make([]int, 0, 20) 就是 20,一个不多。
这个差别在二十个元素上微不足道,换成二十万个就不一样了,省的不只是那点内存,更重要的是省掉了中间几次复制和几次垃圾,十万个元素按默认方式长起来,中途要复制十几万次元素,这些旧数组全部得等 GC 来收,那是实打实的停顿来源,而且每一次扩容的瞬间,新旧两块内存同时活着,峰值会比稳定状态高一截。
我拿二十个试过,差十二个槽。
我盯着内存曲线看过一次,那一下是斜的。
三千个切片,平均用三成。
这个峰值在大对象上特别难看,一个装了几万个结构体的切片,扩容的一瞬间内存占用可能翻倍,如果你的服务本来就贴着内存上限跑,这一下就够把进程顶掉。代价是估错方向。预分配多了,多出来的容量在整个生命周期里都占着(尤其是这个切片会被存进一张大表的时候),容量会跟着一起留下来。
我吃过一次亏,一张缓存表里存了几千个切片,每个都按上限预分配,实际平均只用到三成,内存直接涨了两倍,排查了半天才想起来是当初那句看着很负责的 make。
估错方向的代价不会当场显出来,它跟着那个切片一起活到被回收为止,麻烦的是事后很难指认是哪一次分配造成的,profiler 只告诉你哪个类型占得多,不告诉你当初那句 make 是照着什么估的。
所以后来我改成先按经验值给一个,跑一阵子看实际长度分布,再把预分配的量调到那个分布的九十分位附近,剩下的靠扩容补,这样既躲开峰值,也不至于把容量长期锁死在一个用不到的尺寸上。
六个现象,六个原因
| 现象 | 原因 |
|---|---|
| 512 之后是 848 不是 1024 | 容量过 256 后走 1.25 倍递推,再被分配器向上取整 |
| 元素类型不同,台阶不同 | 分配器按字节分级,不按元素个数 |
append 完的原切片没变 |
触发了扩容,返回的是新头部 |
两次 append 结果一样 |
写的是同一格,且都落在容量内 |
| 三索引切片后原数组还是变了 | 它只限容量,不隔离元素读写 |
| 预分配反而更占内存 | 按极限值分配,实际用不到 |
写到这里我大概明白了一件事,切片的容量数字不是给你背的,它是让你在看到一个怪数的时候不慌,知道它是三步算出来的就够了,至于那三步里具体的常数,记不住也没关系,翻一眼源码就有。848 现在看着挺顺眼。