Go 的内存泄漏,泄漏的是引用不是内存
Go 的内存泄漏,泄漏的是引用不是内存
隔壁老康难度 ★★★★☆ · 前置:把 gctrace 那一行拆开,每个字段对一遍 | 一句话结论:GC 判的是可达,只要还有一根指针指着,那个对象就收不走,所以查泄漏要先找谁还拿着,而不是先问谁该被释放。
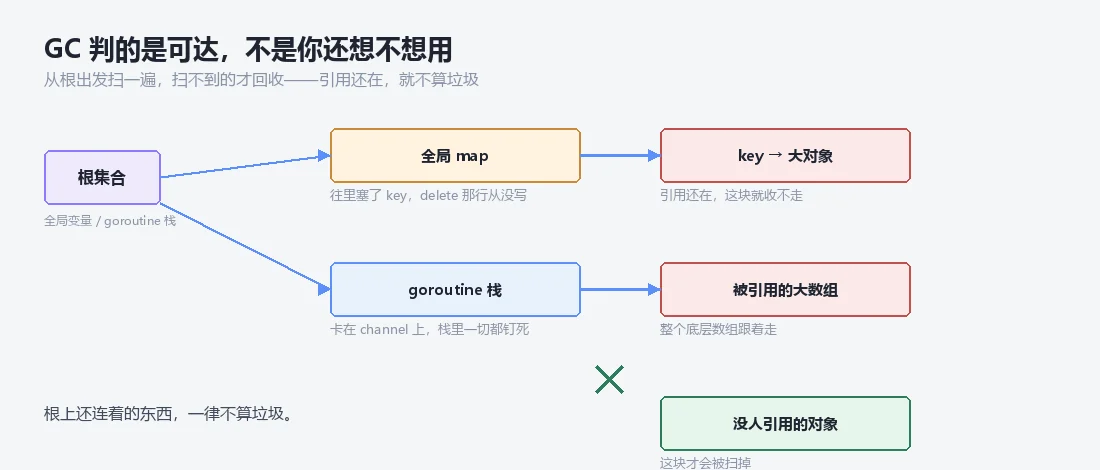
GC 判的是可达,不是你还要不要用
Go 带 GC 这件事,很容易让人把内存管理整个外包出去,觉得只要不忘记释放,就不会有泄漏。真写起来才发现,泄漏并没有消失,只是换了个形状。手动管理的语言漏的是内存本身,你分配了却没还回去,账很好对。Go 漏的是引用,某处还攥着一个指针,对象就一直被判为活着,它下面挂着的整棵树都不收。回收器每天做的事是把不可达的东西扫掉,它看不出你那个指针其实早就不打算用了,它只认有没有人指着。所以我排查内存问题的时候,第一个问题从来不是内存去哪了,而是谁还拿着,这个问题能问出方向的概率比前一种高得多。换个说法,回收的判断标准是可不可达,不是还要不要用。代码里少写一句删除,回收器就真的收不到,因为从它看的那张图上,那条路径确实还连着根,中间没有任何一处断掉。想通这一层,后面几种形状其实都是同一件事的不同摆法,都是某处不该留的引用没断干净:
| 漏在哪儿 | 被钉住的是什么 | 怎么认出来 |
|---|---|---|
| 全局 map 只进不出 | 每个 key 一路挂下去的那棵树 | map 长度稳步往上走 |
| goroutine 卡在 channel 上 | 它栈上活着的所有引用 | NumGoroutine 回不掉 |
| 切一小段留一大块 | 整个底层数组 | inuse_space 和切片长度不匹配 |
| Ticker 没 Stop | 定时器和它的闭包 | 两个 heap 相减才看得见 |
这个道理我一开始并不真懂,有回盯着一份 heap profile 逐行看,每一行都合理,却没有任何一行在回答我的问题(我一直在找哪个类型占用最大),最后发现问题不在类型上,而在于有个结构体被一个早该退出的 goroutine 攥着(那阵子我认定 profile 里数字大的就是凶手,方向整个是反的)。
全局 map 只进不出,delete 那行永远没写
做缓存最顺手的东西是全局 map,一行声明,随便哪个包都能塞进去,写起来比任何方案都快。问题在于它的生命周期跟进程一样长,你往里放的时候顺手,取的时候也顺手,但没有人负责把它拿出来。最常见的形态是写入处带了判断,只有查不到才写,写得挺讲究,删除那边却是空的,或者只在一个几乎不会走的失败分支里删一次。请求一多,key 就一次次累加,每个 key 背后挂着一个结构体,结构体里再挂着切片,图就这样一层层铺开。它不是突然涨上去的,每天涨一点,监控上看像正常波动,等你发现的时候基数已经很大了。这一类的隐蔽之处在于堆上没有任何异常对象,每个 key 都合理,每个 value 都有用过的痕迹,没有哪个看起来像垃圾。你甚至能从里面读出业务,一眼看出它是哪次需求塞进去的,就是看不出它凭什么一直留着。我遇到的那次拿它存会话状态,删只在登出的分支上做,可大部分请求根本走不到登出,于是那些会话一天天攒着,攒到内存顶到机器的上限,重启之后一切正常,隔了好一阵才又顶上去一次。那次我一开始怀疑的是序列化太费内存,把几个编码库换了一圈也没变化,最后还是把 map 的长度打出来才看见它在稳步往上走(之前连想都没往这里想,因为那行声明实在太顺手了)。后来我在代码评审里养成了一个习惯,看到全局 map 就先找 delete 在哪,找不到就问一句什么时候删,答不上来就说明还没到能上线的程度,那不是先跑起来再说的问题,是设计上就少了一块。
goroutine 卡在 channel 上,栈上一切都跟着钉死
goroutine 泄漏比 map 难查,因为堆上的数字可能是平的。一个 goroutine 卡在往无缓冲 channel 发送上,只要对面没有接收方,它就永远停在那一行,调度器不会分给它任何 CPU,CPU 的 profile 上完全看不见它。它自己的栈很小,看起来微不足道,真正的代价是栈上活着的那些引用。传进去的切片、结构体、闭包捕获的变量,全都被这个停住的 goroutine 钉在原地,回收器从它的栈根出发,把那一片全标成存活。于是会出现一种很别扭的现象,goroutine 数量在涨,堆也跟着涨,但 heap profile 里最大的那一类对象看起来平平无奇,因为账记在数量上而不是单个对象上。这类漏法靠盯堆的曲线基本看不出来,只能换个口径去数,数的对象不是字节而是人。查这一步只看一个数,runtime.NumGoroutine 是不是在缓慢往上走。稳态下的服务这个数应该接近一条平线,波动之后会回落到同一个水平,回不去的部分就是漏掉的。这个数看起来粗糙,却是最不容易被骗的证据,因为堆的曲线可以被 GC 周期搅乱,它不会。我第一次靠它定位,是一个 worker 池压测跑着跑着,goroutine 数量就一直往上爬,怎么都不回落,堆的曲线倒是漂亮的锯齿,谁看都觉得正常,我把这个数和请求量画在同一张图上,两条线一个平一个往上走,问题就露出来了(那之前我一直怀疑是某个包在缓存东西,翻了两天源码才发现是 channel 那头没人接)。
还有一种更绕的,goroutine 在等一个永远不会被 close 的 channel,或者等一个只在异常路径上才发送的 channel,这类地方读代码时看着都对,因为发送和接收两边都写了,缺的是那条把两边连起来的路,路径断了但代码各自成立,最费时间的就是这种。
1 | func consume(ch chan int) { |
切一小段留一大块,底层数组整块都走不掉
切片切出来的东西共享底层数组,放到内存上就是一个放大器。一个大缓冲区解析完之后,你只取其中很小的一段返回出去,那个小切片仍然指着原来那整块,回收器看到的是一条从切片指向数组的路径,整个数组都得跟着留下来。
你以为留下来的只是一小段引用,实际留下来的是整块底下的数组,比例可以差得很远,这种情况在解析二进制、读大文件、切日志行的时候特别多,因为那些地方天然就是一整块进、取一小段出。
所以解决办法只有复制,把要的那段抄到新分配的切片里再返回,中间那份大块才有可能被收掉,而 cap 也在这里添乱,拿这类切片继续 append,新元素会写进那块大数组剩下的空间里,行为上是省的,内存上是把大块继续绑住,绑得比你想得久。
判断有没有踩这一条,看代码里有没有从大缓冲区切一段长期存起来的写法(尤其是把切片塞进结构体字段或者放进 map 持有的地方),切片塞进结构体之后,那个字段所在的整个对象也会跟着活下来,留下来的不是那段缓冲区的切片,而是它背后那整块数组。
1 | func firstLine(buf []byte) []byte { |
Ticker 不 Stop,运行时替你一直拿着
一个没 Stop 的 Ticker,到底替我拿住了多少东西?打开那段代码,Delete 一个不少。
time.Ticker 是另一种容易被忘掉的东西。它被创建出来之后由运行时持有一份引用,你不再用它也没关系,只要没调 Stop,它就一直在那里按周期触发,跟着它的 channel 和 channel 上挂的东西一起留着,即使创建它的那个函数早就返回了,运行时的表里还躺着这一条。
写循环里带超时的时候很常见,每进一次循环新建一个 ticker,Stop 写在了 defer 上,函数却要跑很久才退出,中间已经攒下一堆停不下来的 ticker,它们各自还牵着上下文里那条链。context 那一边类似,用 WithTimeout 或者 WithCancel 拿到的 cancel 函数不调,挂在上面的 timer 不会被释放,context 树里那一条支路也一直连着父节点,这两样东西本身都很小,作用却是让整条链上的东西都留着。
这类泄漏在 heap profile 里通常看不出来,单个对象太小,数量也不够多,涨的是运行时内部持有的那部分,我当时是靠内存曲线和 goroutine 数量对不上才发现方向不对的,两个数一个涨一个平,说明问题不在自己的对象上。
那段代码里唯一跟时间有关的东西就是 ticker,写在 defer 里也得真的走到,这句话我原本当作常识,直到在一个长驻的连接处理函数里见到它失效,才反应过来那行写在 defer 里的 Stop 从来没被执行过。
还有一种变形是把 ticker 存进 map 里按 key 缓存,key 变了不清理,旧的那些会一直挂在 map 和运行时两头,两头都不放,这种最难从一处代码里看出来。
1 | t := time.NewTicker(d) |
先数 goroutine,再看 inuse,最后才谈分配
顺序反过来的代价是你会先陷进堆的细节里。
真出了内存问题,顺序比技巧重要。我现在的做法是先看 goroutine 的数量有没有在涨,这一步几乎不花时间,一个接口就能拿到,如果它在涨,后面看堆之前基本已经有方向了,不用急着去抓 profile,数量这一个数就能把八成的方向排掉。数量平稳再看 heap profile 里的 inuse_space,按大小排序看谁占大头,这一步回答的是现在堆上是谁,而不是谁把它弄大的。
inuse 平稳但进程内存还在涨,那就换 alloc_space 看分配速度,谁分配得最凶,谁的嫌疑最大。最后再抓一份 goroutine 的 profile,看它们分别卡在哪一行,如果一堆 goroutine 都停在同一个 channel 操作上,那一段代码就是问题所在,同一个位置堆起来的人越多,那里越像入口。
这套顺序走下来通常就够定位了,还定不下来的时候我才去翻代码,因为带着 profile 翻代码比空手翻要快,注意力有地方放,知道自己在找什么。
抓到一份漂亮的 profile,每一行都看不出问题,因为问题根本不在堆上。
工具本身没什么可讲的,go tool pprof 里 top 和 web 两样用熟就够,关键是每一份 profile 你都清楚自己在看什么口径,看错口径比不看更费时间,还容易得出反向的结论,我见过最快的一次是把这个顺序倒过来验证,先数 goroutine 发现它在涨,再抓 profile,很快就落到那行 channel 上。
两份 heap 相减,比单看一份有用得多
单份 heap profile 的用途比人们想的要小。它告诉你现在活着的对象按类型分布成什么样,但活着的对象里有一大半本来就该活着,你很难从一张静态的图里分出哪一部分是不该留的。真正有用的是 diff,两个时间点各抓一份,中间让服务跑一段,然后用 base 参数把基线和新的那份一起喂进去,看新增的是哪些类型,正常的分配和释放会把增量压下去,只有不停地留下的那一类才会在两个时间点之间稳定变多。抓的时候要注意对齐,业务量的变化会污染对比结果,最好挑两个负载差不多的时刻,抓之前先跑一次强制 GC 会让结果干净很多,否则你会把还没来得及回收的临时对象也算进新增里,凭空多出一批嫌疑人,然后挨个去查。我第一次用 diff 是拿它去证伪自己前面的判断,单份图上那段长得最凶的类型,在两份相减之后根本不在增量里,那一刻才知道前面一圈排查的方向一直是错的。
1 | go tool pprof http://127.0.0.1:6060/debug/pprof/heap |
缓存得先有上限,再谈删哪一个
定位到之后的那一步通常最难。
缓存这一类问题最后都要落到容量上。你没法靠删解决问题,因为光看一个 key 你不知道它该不该删,热度、大小、最近一次访问,这些信息不在 key 里。所以方向应该是让它一开始就有上限,LRU 也好,带 TTL 的淘汰也好,核心是让写入这条路径上有一个必然发生的删除动作(而不是等你想起来了再删),真正需要拦住的是写入口,不是写完之后的一堆补救(这一点想明白之后),缓存那个模块的对外接口会跟着简单很多。
TTL 解决的是过期,容量解决的是总量,两样都需要,只有 TTL 的时候突发流量仍会把总量顶上去,只有容量的时候热点可能被误伤,两样都缺的时候,缓存就退化成一个只进不出的 map。
写自己的缓存我会先把这两条定下来,然后才去写 get 和 set,顺序反过来,后面补淘汰逻辑时就要改一堆调用点,而且改的时候很容易漏掉某个写入路径。
真实项目里更多用的是现成的库,选的时候看一眼它有没有淘汰策略,没有的那基本就是个 map 套一层壳,用久了还是同一个结局。
还有一层容易忽略,缓存里放的是指针的时候,淘汰一个 key 只是把它从 map 里摘掉,别处如果还存着那个指针,对象照样不走,淘汰看着生效了其实没有。
这一条我在一个图片服务上撞见过,缓存里存的是解码后的对象指针,key 淘汰了,另一个列表还按 id 拿着同一批指针,内存一点没降,最后是两条线一起断掉才松开。
写了两年多的 Go,我现在对内存问题比对性能问题更谨慎,性能差一点的代码能跑,内存漏一点的代码也会跑,跑很久才显出问题,那时候你已经很难回忆起当初为什么那么写。
所以我会在写的时候多花一点时间,把每一条长期持有的引用都问一遍它什么时候放手,map 的 delete 写在哪里,goroutine 从哪里退出,切片要不要复制,ticker 会不会 Stop,问的姿势也简单,就是看着那一行想,这个东西凭什么活到明天。
答不上来的地方就是以后要查的地方,GC 替我们省掉的是释放这一步,判断该不该释放这件事从来没被省掉。