结构体与方法:Go 的对象就这么回事
结构体与方法:Go 的对象就这么回事
隔壁老康难度 ★☆☆☆☆ · 前置:切片与 map:Go 的集合就这两个 | 一句话结论:结构体把字段打成一块连续的内存,方法是挂在类型上的普通函数,嵌入则是把内层结构体摊平进外层的内存布局里。
一行声明,四种建法
结构体的声明短得有点意外。
type Point struct 后面跟一对大括号,括号里每个字段占一行,字段名在前、类型在后,语序和 var x int 完全一致,学过变量声明的人不用再学第二套语法。两个同类型的字段可以挤在一行,X, Y int 跟拆成两行写完全等价,编译器看到的是同一个东西,省下来的只是纸。字段名头一个字母决定可见性,大写对外公开,小写只在包内可见,这条规矩在结构体里跟在包级别上一模一样,没有为结构体单开一套。字段之间不写逗号也不写分号,换行本身就是分隔符,所以排版怎么变形都不影响语义,gofmt 会把它拉回标准样子,团队里也不必为对齐争吵。还有一点得先说清楚,结构体只是字段的集合,方法不写在里面,字段和方法是两处定义、一个类型,这一点跟 Java 或 C++ 的类差别最大,也是我当年从 Java 转过来最别扭的地方。结构体本身是值类型,不是一个引用,这句话从声明里看不出来,但要先记住,后面所有关于复制和指针的疑惑都从这儿长出来。
1 | type Point struct { |
建一个 Point 有四种写法,四种我都真打了一遍。带名字的把字段名写出来,顺序随便,写哪个不写哪个也随便。不带名字的按声明顺序填,少写的字段自动补零值。第四种是 var p Point,一个字段都不提,整块内存清零。前三种之间不能混用,一半按顺序一半按名字,编译器当场拦下来,这一点下一段就有证据。
1 | a := Point{1, 2} |
1 | $ cd _local/golab/h6/def && go run . |
上面这段里,前四行是 fmt.Println 打出来的,花括号里几个数字挨着,谁是谁根本看不出来,字段一多就彻底瞎了,我头半年最常犯的错就是对着这串数字数第几个。
%+v 是专门照顾结构体的格式,每个值前面挂上字段名,调代码的时候我基本只用它,fmt.Printf("%+v\n", p) 一行下去,X 是几 Y 是几一目了然。
底下三行是零值,没写的字段就是零值,不用谁来初始化,int 是 0,string 是空串,指针和接口是 nil,切片和 map 也是 nil。nil 切片照样能 append,nil map 读不崩、只崩写,所以 var d Point 拿到手就能用,不必像某些语言那样先 new 一个空壳再挨个填。
混合写法的报错贴在这儿,行号指着哪一行写得很清楚,编译器的提示一如既往地把该写什么写进了英文句子里。
1 | $ cd _local/golab/h6/mixed && go build ./... |
建结构体就这四种写法,没有第五种。
匿名结构体只在那一次用
p := struct{ Name string }{Name: "a"} 不给类型起名字,定义和创建挤在一行,上面输出的末行就是它的类型。这种写法适合只出现一次的地方,测试里凑一张表、临时拼一段要发给接口的 JSON,都挺顺手,用完就扔,不必污染包里的类型清单。代价是类型没法引用,struct { Name string } 换个位置再写一遍就是另一个类型,两边不能互相赋值,一旦要复用就得老实起个名字,不能靠运气。
方法是带了接收者的函数
方法就是多了一对括号的函数。
1 | func (p Point) Dist() float64 { |
那对括号里的 p 叫接收者,类型是 Point,func (p Point) Dist() 读作给 Point 挂一个 Dist。调 p.Dist() 的时候 p 被塞进括号里当普通变量使,方法体拿到的是一个 Point,不是指针也不是引用,这就是值接收者的全部含义。
值接收者拿到的是一份复制品,这句话不跑代码很难真记住。我加了 TryMove,在方法里把 X 和 Y 各加十,再把方法里看到的值打出来,外面再看一次。
1 | func (p Point) TryMove(dx, dy int) { |
1 | $ cd _local/golab/h6/method && go run . |
中间那两行是整节的要害。方法里是 13 和 14,出了方法还是 3 和 4,p 只是个形参,进来的时候复制了一份,方法里改的是副本,方法一结束副本就扔掉,外面那个 Point 一个字节都没动,连它的地址都没变过。这也顺带解释了另一件事,给结构体加方法不用操心副作用,值接收者的方法天然是纯的,除非你把副本里的指针字段也顺手改了,那是另一回事,属于藏得比较深的坑。读字段则完全不受影响,Dist 读 p.X 和 p.Y,算的是 3 和 4 的斜边正好 5,副本里的值和原件一样,读谁都不出错,所以查询、格式化、计算这类方法,值接收者就够了,连想都不用想。真正需要指针接收者的只有一种情况,你要让调用方看到改动。
还有一个方法名是固定的,String(),实现了它,打印的时候就会自动走你的版本。
1 | func (p Point) String() string { |
1 | $ cd _local/golab/h6/stringer && go run . |
四行分别是 Println、%v、%+v、%#v,前三个全走了 String,只有 %#v 还在打结构,这意味着上一节教的 %+v 会被你自己写的 String 顶掉,调试时反而不如不写。
值接收者管读,指针接收者管写。
想改到外面,接收者得是指针
把接收者的类型从 Point 换成 *Point,p 就成了地址,方法里改的就不再是副本。p.X += dx 会自动解引用,不必写成 (*p).X,这层编译器替你办了,写起来和值接收者一模一样,看不出区别。调用有两种写法,都能过,p.Move(1,1) 和 (&p).Move(1,1) 指的是同一个对象,不存在哪个更对,第二种只是把编译器偷偷做的事情写在了明处。能自动取到地址的前提是 p 是个变量,编译器知道它在内存里的位置,所以能替你取,换成字面量就没这待遇,Point{1, 1}.Move(1, 1) 编译不过,因为它没有地址可取。
1 | func (p *Point) Move(dx, dy int) { |
1 | $ cd _local/golab/h6/badaddr && go build ./... |
这句报错我盯了半天才明白,Move 明明定义过,报的却是 cannot call,问题不在方法存不存在,在于那个值放不进地址。先把字面量赋给一个变量,同样的调用立刻就能过,编译器要的只是一块确定的、能算出偏移的内存。
map 里躺着的结构体也是同一个道理,m["a"].X = 9 编译不过,因为 map 里的值不是可寻址的变量。赋值本身也是复制,跟接收者是不是指针无关,b := a 复制一整块,c := &a 才算共享,这个差别值得单独跑一遍。
1 | $ cd _local/golab/h6/mapfield && go build ./... |
1 | $ cd _local/golab/h6/assign && go run . |
b 改 X 不影响 a,b := a 复制了一整块。c 是 &a,改 c 就是改 a,两个名字指向同一块内存,谁改都算数。后两行是容器里的结构体,从 map 里取出来的是副本,改副本不动原件,这也是 map 那一行的病根。切片可以直接写 s[0].X = 50,因为下标表达式本身能取地址,编译器算得出偏移,从切片里 v := s[1] 拿出来的又不行了,一旦赋值给变量就又是一份复制。
规则记成一句最省事,一个类型只要有一个方法用了指针接收者,其余方法统统改成指针,省得每次调用都要现场判断。
New 开头不是语法,是习惯
Go 没有构造函数,NewPoint 只是一个普通函数,编译器不认这个名字。社区约定用 New 开头、返回指针,纯粹是让人一眼看出该调它而不是直接 Point{}。
1 | func NewPoint(x, y int) *Point { |
1 | $ cd _local/golab/h6/ctor && go run . |
内建函数 new(Point) 也能拿到指针,可它只会清零,一个字段都指定不了,实际写代码基本用不上。&Point{} 效果一样,写法更顺,我一般写这个。末行是指针自己的零值,nil,没指向任何结构体,这时候读 z.X 会直接崩,判断 nil 是调用方的事,构造函数管不了。
嵌入:内层结构体被摊进来
组合靠嵌入。
1 | type Base struct { |
Derived 里那行 Base 就是嵌入,不带字段名,字段名默认取类型名,所以它就叫 Base,写 Derived{Base: Base{ID: 7}} 时那个键就是它。造一个出来,字段和方法都能直接点,d.ID 和 d.Hello() 都通,仿佛 ID 和 Hello 本来就长在 Derived 身上。
1 | $ cd _local/golab/h6/embed && go run . |
前面几行是字段提升,d 上压根没有 ID 这个字段,编译器往上找了一层。d.ID 和 d.Base.ID 是同一块内存的两种写法,写过一个另一个跟着变,那个 99 就是这么来的。方法也一样,Hello 挂在 Base 上,Derived 通过嵌入把它借了过来,调 d.Hello() 时接收者其实是 d 里那个 Base,不是一个独立的副本。
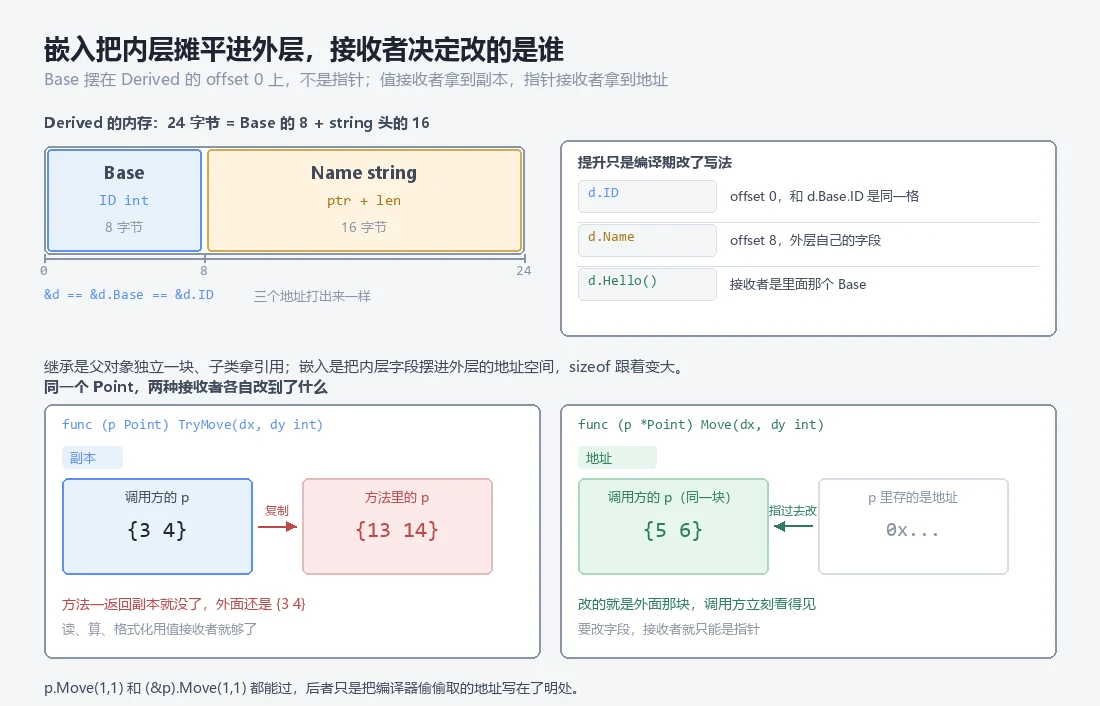
后面几行是偏移量,这才是嵌入和继承真正的分水岭。Base 偏移 0,Name 偏移 8,整个 Derived 24 字节,正好是 Base 的 8 加 string 头的 16,三个地址打出来一模一样,说明 Base 就摆在那儿,不是指针指过去的。继承里父对象是独立的一块,子类拿着引用,嵌入是把字段摊进外层的结构,sizeof 会跟着变大,复制的时候内层那份也复制一次,两个结构体之间没有隐藏的指针,也没有虚函数表之类的东西。嵌入改的是内存布局,不是套了层壳。
同名的时候谁说话
外层和内层撞上名字,外层的赢。
1 | type Named struct { |
1 | $ cd _local/golab/h6/shadow && go run . |
o.Name 拿到的是 outer,o.Named.Name 才是 inner。方法同理,Outer 自己的 Who 把 Named 的遮住了,想调内层必须写全路径。遮蔽不是删除,内层那份还在,只是不自动露出来,复制、比较、JSON 里都还看得见它。两个同级嵌入都带 Name 就更干脆,谁都不提升,编译器直接报歧义,写全 c.A.Name 或者 c.B.Name 才过。
1 | $ cd _local/golab/h6/ambig && go build ./... |
能不能比,JSON 长什么样
字段全都可比较,结构体就能用 ==。
1 | $ cd _local/golab/h6/cmp && go run . |
这段输出信息量大,慢点看,我把三件事塞在了一起。前半段是能比,两个 Point 字段都对上就是 true,换成 2 和 1 就是 false,数组也是按元素比的,元素能比数组就能比。里面还有一个坑,结构体里只要有一个切片、map 或者函数字段,整个类型就不可比较,== 在编译期就失败,不是留到运行时才炸,这一点比运行时报错友好得多,至少不用等线上。后半段的 JSON 是入门阶段最实用的部分,tag 写在字段类型后面,用一对反引号包起来,json:"name" 决定序列化之后的键名,omitempty 让零值字段整个消失,所以 Age 是 30 的时候有一项,写成 0 就没了,Mail 空着也一并没了,这一点在给前端做接口时特别好用,省得前端到处判 null。
1 | $ cd _local/golab/h6/badcmp && go build ./... |
1 | $ cd _local/golab/h6/embedjson && go run . |
反序列化那一行 name 和 age 都塞进了对位的字段,没写出来的 Mail 留空,不会报错。没有 tag 的类型直接用大写字段名当键,小写的 age 压根不会出现在 JSON 里,因为它没有导出,这跟字段可见性是同一条规矩,不是 JSON 包的额外要求。嵌入的结构体在 JSON 里被摊平,不会多出一层 Meta,写接口的时候很省事,公共字段抽成一个 Meta 塞进去,序列化出来还是平的,反序列化也按同样的形状对回去,两头都不用特殊处理。
结构体这一块到这儿就齐了,剩下的都是它的组合方式。